- Definición de los metadatos como la infraestructura invisible que describe y organiza la información digital.
- Clasificación detallada según su función, contenido y variabilidad para optimizar la recuperación de activos.
- Aplicaciones estratégicas en ciberseguridad, cumplimiento normativo (RGPD) y desarrollo web mediante metatags.
- Análisis de los retos actuales en la estandarización y la automatización mediante inteligencia artificial.

Seguro que alguna vez has escuchado que vivimos sumergidos en un mar de datos, pero lo que poca gente comenta es que ese océano tiene un sistema de etiquetado invisible que lo hace manejable. Hablamos de los metadatos, esa capa de información que, básicamente, son datos que describen a otros datos. Imagina que tienes un libro: el contenido de las páginas son los datos, pero la ficha de la biblioteca con el nombre del autor, el año de publicación y el género son los metadatos. Sin ellos, encontrar algo específico en la red sería como buscar una aguja en un pajar.
A nivel técnico, estos elementos actúan como una ficha técnica detallada que separa el contenido real de su contexto. No importa si hablamos de una simple foto en el móvil, un informe financiero complejo o una base de datos relacional; los metadatos están ahí para decirnos quién creó el archivo, cuánto pesa, cuándo se modificó por última vez o qué permisos de acceso tiene. En un mundo donde las empresas mueven volúmenes de información brutales, saber gestionar estas etiquetas no es solo un capricho técnico, sino una necesidad estratégica para no perder el control de los activos digitales.
Clasificación de los metadatos según su utilidad
No todos los metadatos hacen lo mismo. Dependiendo de lo que necesitemos resolver, podemos dividirlos en varias categorías principales:
- Metadatos descriptivos: Son los más habituales y sirven para identificar el recurso. Aquí entran el título, las palabras clave, el resumen y el autor. Su gran valor reside en que facilitan la indexación y la búsqueda de información en motores de búsqueda o catálogos.
- Metadatos estructurales: Estos nos indican cómo está montado el recurso internamente. Por ejemplo, en un libro electrónico, nos dicen cuál es el orden de los capítulos o cómo se relacionan las páginas entre sí, estableciendo una jerarquía lógica.
- Metadatos administrativos: Se centran en la gestión del archivo. Dentro de este grupo encontramos los técnicos (formato del archivo, resolución, software usado), los de derechos (licencias Creative Commons, propiedad intelectual) y los de preservación, que aseguran que el archivo sea legible a largo plazo (como el estándar PREMIS).
- Metadatos de uso: Registran la interacción con el archivo, como el número de veces que ha sido abierto o quién accedió a él y en qué fecha.
Otras formas de categorizar la información meta
Más allá de la función, existen otros criterios para clasificar estos datos que son muy útiles en entornos de programación y análisis de datos. Por un lado, tenemos la distinción según su contenido: algunos describen el recurso en su totalidad (el contenedor) y otros describen lo que hay dentro del recurso (el contenido propiamente dicho). Es como diferenciar entre la etiqueta de una caja y la descripción de los objetos que hay dentro.
También podemos fijarnos en su variabilidad. Existen los metadatos inmutables, que no cambian independientemente de cómo veamos el recurso (como el nombre original de un archivo), y los mutables, que pueden variar según la ubicación o el contexto de visualización. En ámbitos más académicos o de IA, se habla incluso de capas funcionales: niveles subsimbólicos, simbólicos y lógicos, donde estos últimos permiten deducir conclusiones automáticas mediante la representación del conocimiento.
Aplicaciones prácticas en el mundo real
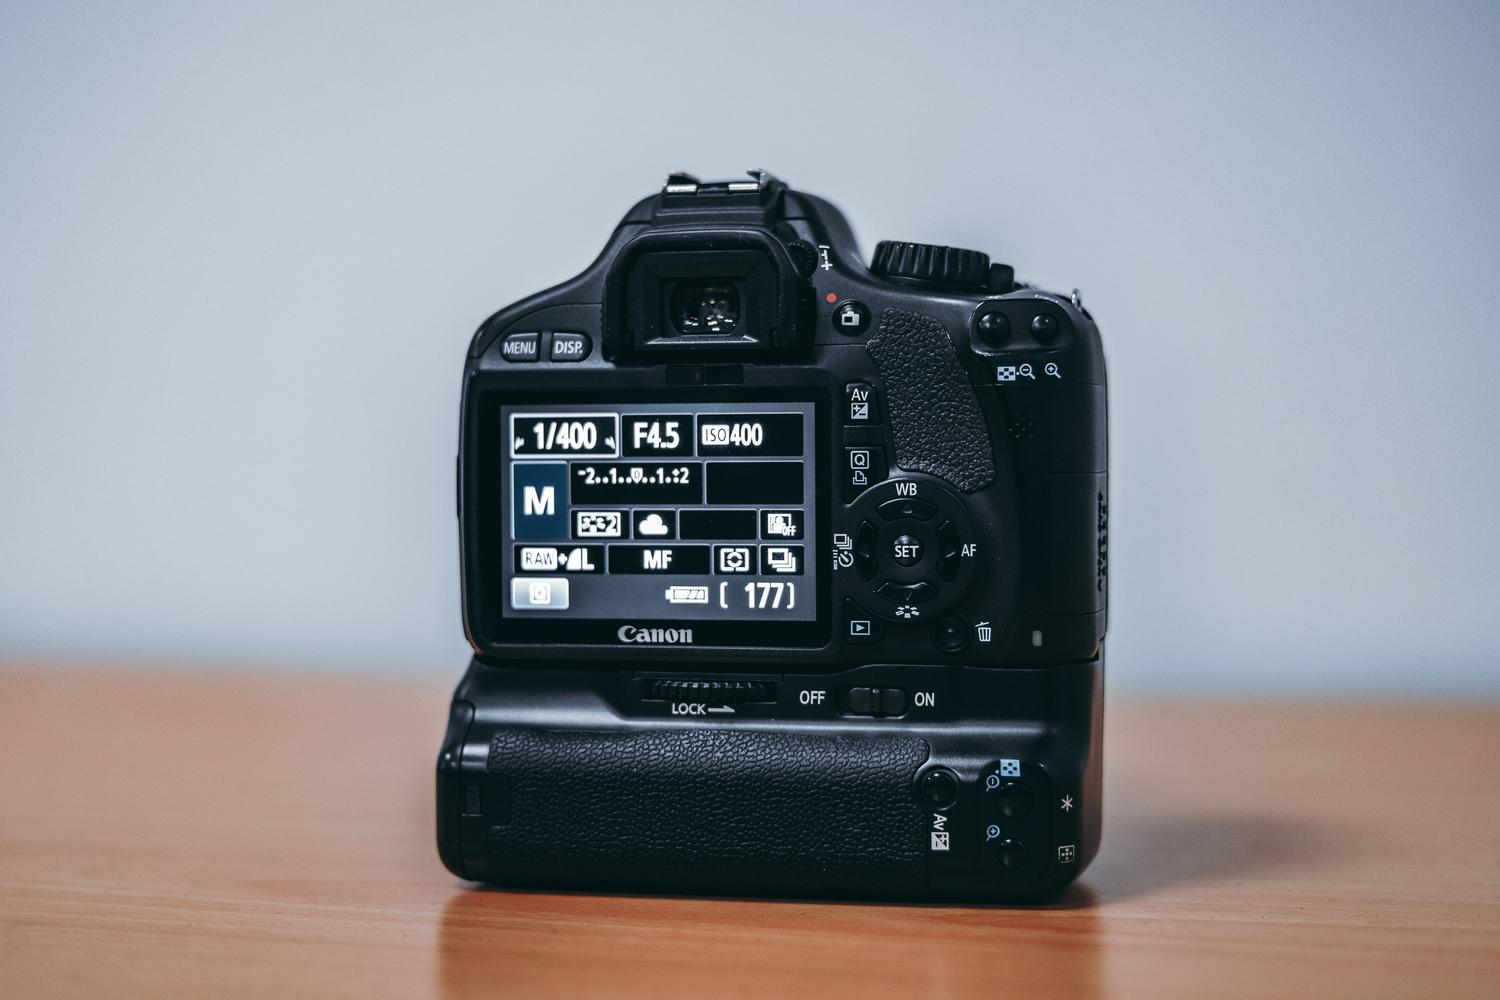
Para que no se quede en teoría, veamos dónde nos encontramos con los metadatos en el día a día. En la fotografía digital, cada vez que disparas con el smartphone, se crea un archivo EXIF que guarda la ubicación GPS, el modelo de cámara y la apertura del diafragma. En el correo electrónico, las cabeceras que indican el servidor de origen y la hora de envío son metadatos puros.
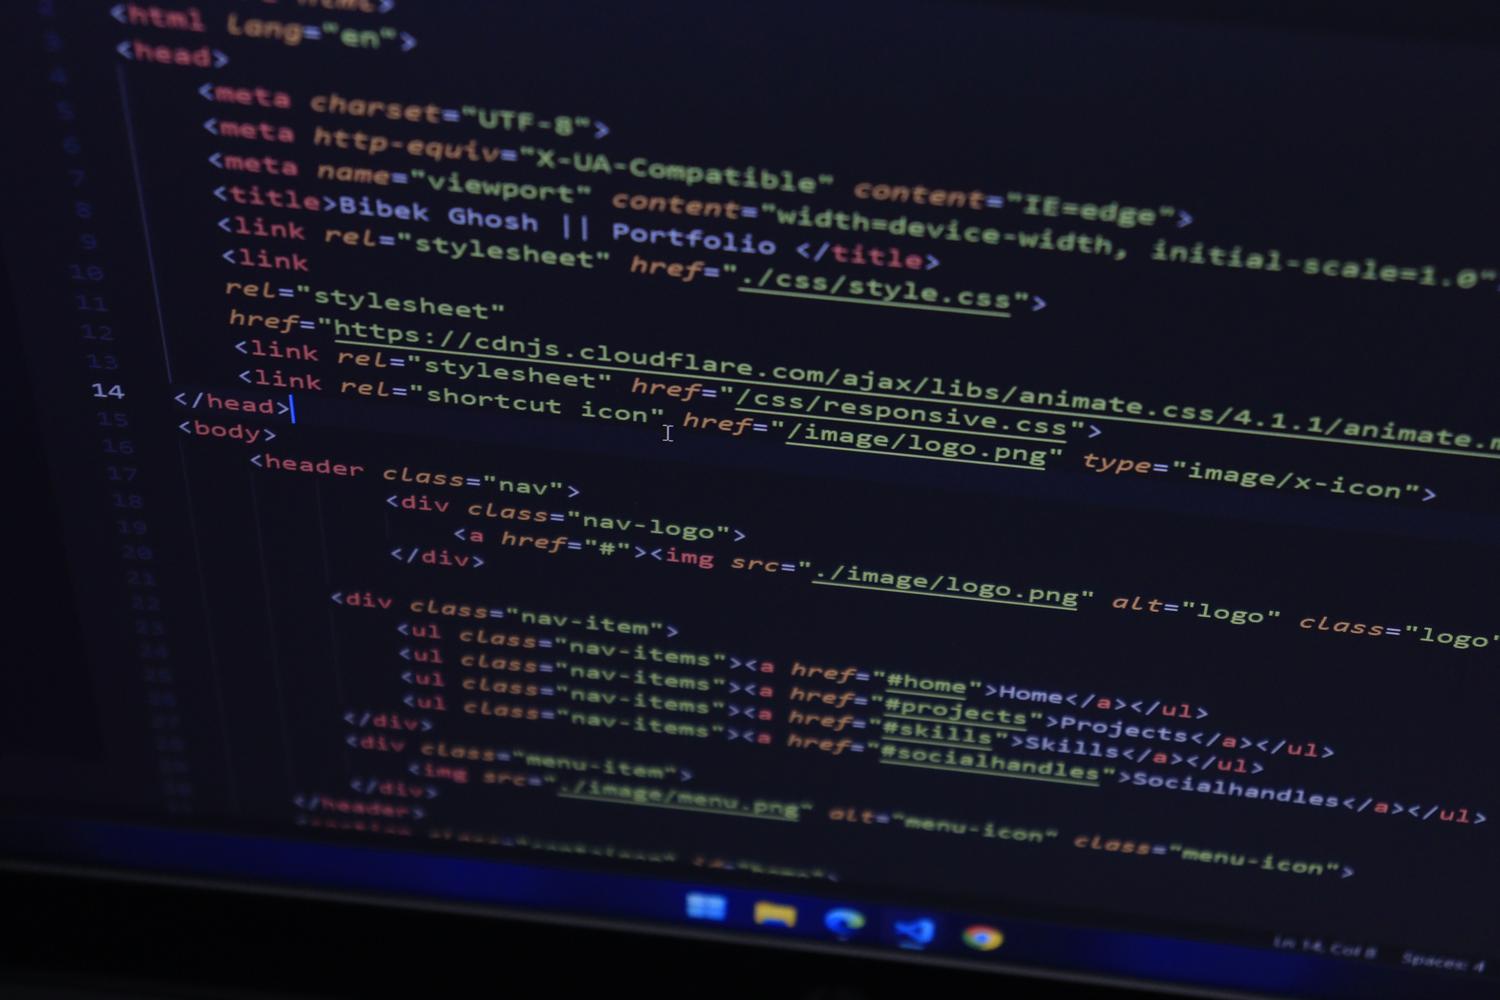
En el ámbito del desarrollo web, las metatags de HTML son fundamentales. Existen etiquetas generales como description y keywords que ayudan al SEO, y etiquetas HTTP que controlan el comportamiento del navegador, como el refresh para recargar la página o el content-type para definir el tipo de documento. Además, en las redes sociales, cada interacción (un like, un follow) genera metadatos que las plataformas usan para crear perfiles publicitarios hipersegmentados basados en nuestros hábitos.
Metadatos, Ciberseguridad y Cumplimiento Legal
Hoy en día, los metadatos son el brazo derecho de la ciberseguridad. Gracias a ellos, las empresas pueden aplicar políticas de clasificación automática. Herramientas avanzadas de IA pueden analizar los metadatos para detectar documentos confidenciales y evitar que salgan de la organización, previniendo así la fuga de datos. Esto es vital para cumplir con normativas estrictas como el RGPD en Europa o la CCPA en California, ya que permiten saber exactamente dónde residen los datos personales y quién tiene acceso a ellos.
Implementar una gestión basada en metadatos reduce drásticamente los costes operativos. Se estima que las organizaciones que ignoran este enfoque pueden gastar hasta un 40% más en la gestión de sus datos. Al automatizar la clasificación, se eliminan los errores humanos y se logra una trazabilidad total, sabiendo quién hizo qué cambio y en qué momento preciso.
Desafíos y críticas al uso de metadatos
No todo es color de rosa. Existe una corriente de críticos que argumenta que crear metadatos es una tarea extremadamente costosa y tediosa. El problema principal es la falta de completitud: como rellenar estas fichas es aburrido, mucha gente lo hace mal o lo deja a medias. Además, está el problema de la interoperabilidad; que una institución use un vocabulario y otra uno distinto puede hacer que los sistemas no se entiendan entre sí.
Otro punto conflictivo es la subjetividad semántica. Lo que para un experto es un documento de dificultad \»media\», para otro puede ser \»difícil\». Esto genera inconsistencias que las máquinas no saben gestionar fácilmente, ya que los metadatos suelen estar orientados a humanos y no a procesos computacionales puros. Por ello, se están desarrollando ontologías y folksonomías para intentar estandarizar el significado de los términos y que la IA pueda interpretarlos sin ambigüedades.
Almacenamiento y Ciclo de Vida
Existen dos formas de guardar esta información: de manera interna (dentro del propio archivo, como los ID3 en un MP3) o externa (en una base de datos separada). Actualmente se prefiere la externa porque permite hacer búsquedas masivas mucho más rápidas sin tener que abrir cada archivo individualmente. El ciclo de vida de estos datos pasa por la creación (que puede ser manual, semiautomática o automática), la manipulación y, finalmente, la destrucción controlada.
En sectores específicos como el e-learning, se utilizan estándares como el IEEE LOM para describir objetos de aprendizaje. Esto permite que un profesor encuentre materiales didácticos exactos según la dificultad o el objetivo pedagógico. También han surgido los paradatos, que son los datos generados por la interacción del usuario con el servicio (logs de servidor), permitiendo analizar el comportamiento real para mejorar la experiencia de usuario.
Toda esta infraestructura de información, desde las simples etiquetas de un archivo JPG hasta los complejos sistemas de ontologías en la web semántica, constituye la base de la organización digital moderna. Al combinar la clasificación descriptiva, técnica y administrativa con herramientas de automatización e inteligencia artificial, las organizaciones no solo optimizan sus búsquedas y el SEO, sino que blindan su seguridad y garantizan la supervivencia de sus activos digitales a través del tiempo.